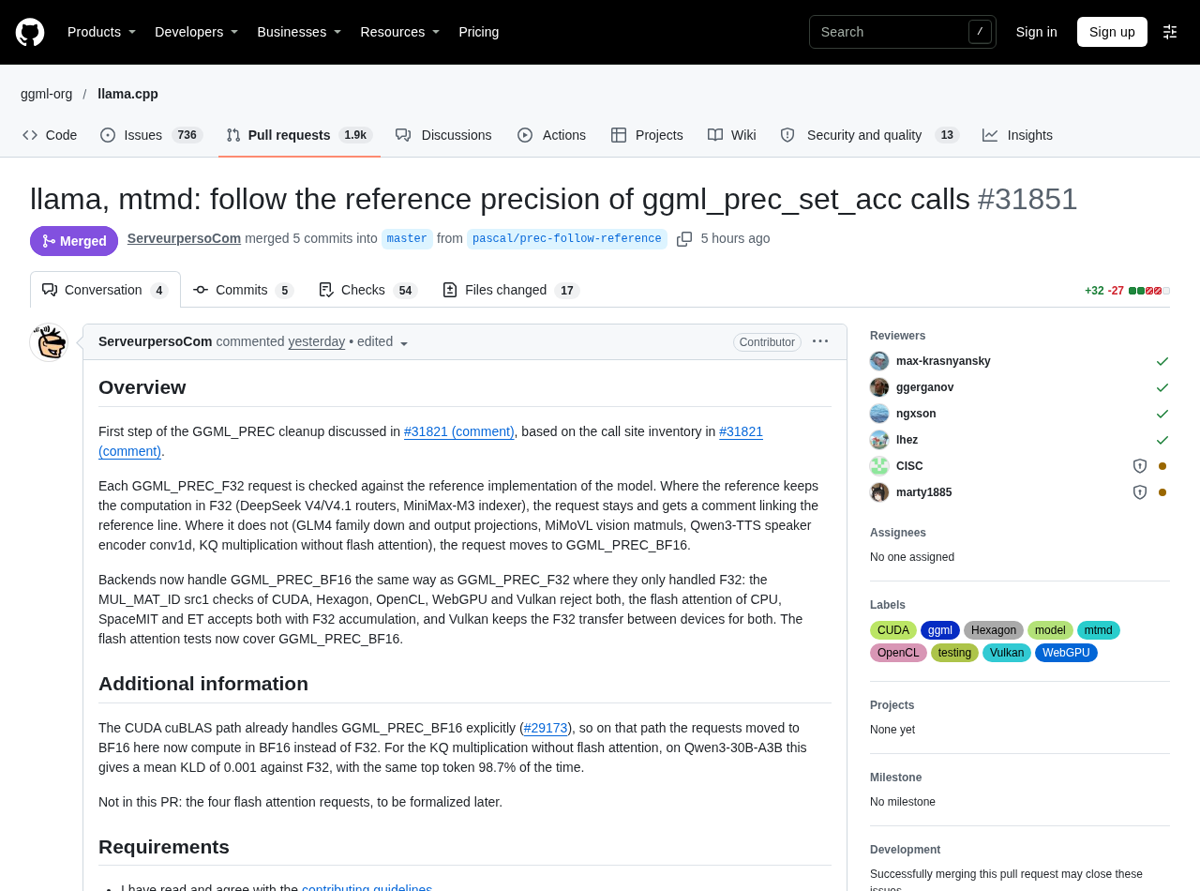
llama.cpp ha publicado la preversión b12202 con un ajuste técnico para acercar determinadas decisiones de precisión a las implementaciones de referencia de los modelos. El cambio #31851 revisa llamadas a ggml_prec_set_acc y no aplica una regla uniforme: donde la referencia conserva F32, llama.cpp mantiene F32; donde no lo hace, la solicitud pasa a BF16. La propia publicación marca b12202 como pre-release, por lo que describe una entrega que conviene evaluar antes de considerarla una actualización de producción.
La revisión afecta a operaciones concretas, no a una etiqueta genérica de “mejor rendimiento”. Según el cambio integrado, pasan a GGML_PREC_BF16 algunas proyecciones de la familia GLM4, multiplicaciones de visión de MiMoVL, la convolución del codificador de locutor de Qwen3-TTS y una multiplicación KQ sin flash attention. En sentido contrario, los routers de DeepSeek V4/V4.1 y el indexador de MiniMax-M3 se mantienen en F32 porque sus referencias hacen ese cálculo con esa precisión. Esa distinción ayuda a leer la novedad como un trabajo de fidelidad por operación y modelo, no como una promesa global de menor coste o mayor calidad.
El parche también amplía el tratamiento de GGML_PREC_BF16 en distintos backends y añade cobertura de pruebas de flash attention. Aun así, la nota técnica deja fuera cuatro solicitudes relacionadas con flash attention para una formalización posterior. La lectura práctica de Signalia es que quienes usen compilaciones locales de llama.cpp deberían probar b12202 con los modelos y aceleradores que realmente operan, comparando salida, memoria y estabilidad frente a su build actual. El cambio puede alterar cómo se ejecutan rutas internas, pero la publicación no sustituye una validación propia de compatibilidad ni convierte la preversión en recomendación automática para todos los despliegues.